-

 国家认可委 CNAS L23010 认可项目:微生物宏基因组 | 16S rRNA扩增子
 二级病原微生物安全实验室
 国家高新企业 | ISO9001认证 | 肠道健康精准检测高新技术研发中心 | 专精特新企业
- 联系电话:+13336028502
- +400-161-1580
- service@guheinfo.com
国家认可委 CNAS L23010 认可项目:微生物宏基因组 | 16S rRNA扩增子
二级病原微生物安全实验室 国家高新企业 | ISO9001认证 | 肠道健康精准检测高新技术研发中心 | 专精特新企业
谷禾健康
2015 年,魏茨曼研究所的 Zeevi 等人在《Cell》发表研究,对 800 名成年人进行为期一周的连续葡萄糖监测,记录了 46,898 次日常进餐,并通过标准化试餐发现,相同餐食可在不同人身上引起显著不同的餐后血糖反应。
研究团队构建了整合餐食信息、血液指标、生活方式、人体测量特征及肠道菌群等数据的梯度提升模型,并在独立的 100 人队列中验证了预测能力。
随后的小样本短期饮食干预显示,依据个体化预测设计的低血糖反应饮食,可降低餐后血糖反应。
同样,身边也有人,在同一时间、同一家餐厅,各吃下一碗一模一样的白米饭,分量、配菜、进食速度都几乎相同。两小时后,两个人测出的血糖曲线,却可能判若两样——一个平稳爬升后缓缓回落,一个陡峭冲高又迟迟降不下来。
问题出在哪?过去几十年,营养学给出的主流答案是:算热量、算碳水、算升糖指数。这套思路也支撑了无数减重食谱和糖尿病饮食指南,也确实帮到了很多人。但它有一个长期被默认为“合理简化”的前提——同一个食物,对每个人意味着同一件事。
然而,越来越多的研究正在得出不一样的结果。有人补了某种“网红营养素”精神焕发,有人毫无感觉甚至腹胀。这种差异不是巧合,也不是意志力问题,而是与每个人基因、代谢状态和肠道菌群构成有关。
于是,个性化营养(Personalized Nutrition, PN)应运而生——它像一位翻译,试图读懂每个人独有的身体说明书。如今,有了AI的帮助,这位翻译或许能更好地梳理基因、代谢与生活习惯中的线索,将复杂的数据转化为更适合个人的饮食建议。
本文将围绕三个问题展开:
AI 如何应用于个性化营养?
肠道菌群在其生物学机制中扮演什么角色?
这些前沿研究又能如何落到日常生活中?
注:本文主要参考 2026 年发表于《Frontiers in Nutrition》的综述《Applications of artificial intelligence in personalized nutrition interventions》,并结合该领域的代表性原始研究进行讨论。
不健康的饮食模式,是肥胖、2 型糖尿病(T2DM)、心血管疾病和癌症背后最大也最可改变的推手之一。说它可改变,是因为它不像基因那样注定;说它最大,是因为几乎每个人都每天都要吃饭。
公共卫生层面长期的饮食建议一般是“平均主义”的:多蔬果、少油盐糖、控制总热量。这些没错,问题在于——对“平均值的人”有效的建议,落到具体的人身上,效果可能天差地别。
Zeevi 研究:相同食物,不同的血糖反应
上面以色列血糖研究研究立下了一条此后被反复引用的原则:餐后反应高度个体化,准确的预测必须依赖“人的特征”,而不只是“食物本身”。
而且,有意思的是,研究中甚至出现了相反方向的反应:对同一个人来说,A 食物可能让血糖平稳,对另一个人却可能让它飙升。个体间差异的程度,甚至超过了饮食干预本身带来的差异。
PREDICT 1 研究:量化餐后代谢的个体差异
如果说 Zeevi 等人的研究揭示了人们对食物的餐后反应存在明显差异,那么英国 PREDICT 1 研究则进一步对这种差异进行了量化。
研究团队分析了 1,002 名英国健康成年人,并在 100 人的美国队列中进行了独立验证。结果显示,不同个体的餐后甘油三酯、血糖和胰岛素反应差异显著,其变异系数分别为 103%、68% 和 59%。反应的“个性程度”各不相同。
研究还拆解了“谁在决定这些差异”:肠道菌群等个体因素解释的餐后血脂变异(7.1%)高于餐食宏量营养素构成(3.6%);而遗传因素的解释力相当有限,仅占血糖反应的 9.5%、TG 反应的 0.8%。这意味着——很多人以为查了基因就能定制饮食,但单靠基因远远不够。
最终,整合了多模态数据的机器学习模型,对餐后 TG 和血糖的预测相关性分别达到 r = 0.47 和 r = 0.77。作为参照,只靠热量或碳水含量的模型预测力要弱得多(后文会介绍,在跨人群验证中 R 值约 0.34–0.40)。
为什么个性化营养需要 AI
个性化营养要整合的信息,来自好几个截然不同的层面:相对稳定的基因组、动态变化的代谢组、对环境极其敏感的肠道菌群,再加上饮食记录、血糖监测、可穿戴设备、电子健康档案等行为与临床数据。这些数据维度高、来源杂、互相关联,还常常缺失——传统统计方法很难同时吃下这么多层信息。
这正是 AI(尤其是机器学习)的用武之地:把多维、异构的数据整合起来,找出人类肉眼和单变量分析看不见的复杂交互模式,最终输出“对你个人而言”的预测与建议。
编辑
第一层:基因组——“出厂设置”
基因组学:揭示营养代谢与饮食反应的遗传基础
高通量测序让研究者能描述遗传变异如何影响营养代谢、饮食反应和疾病易感性。全基因组与候选基因研究已确认了一批与饮食相关的位点,比如:ADRB2、TCF7L2、FABP2、FTO、APOE、MTHFR,它们与血糖调节、肥胖、脂质代谢和营养素处理相关。
举例来说:
FTO变异与能量摄入和肥胖表型相关;
FGF21区域变异与宏量营养素摄入相关;
APOE和MTHFR基因型与疾病易感性及生活方式相关表型相关。
此外,DNA 甲基化等表观遗传指标,还可能捕捉到静态基因型之外的额外生物学差异。
基因预测的局限:遗传风险不等于干预效果
在糖尿病预防计划(DPP)中,无论受试者携带何种 TCF7L2 风险等位基因,生活方式干预都能降低向糖尿病进展的风险,基因型与干预之间没有显著的交互作用。
更值得注意的是,家族史、年龄、性别、BMI、空腹血糖等既定临床危险因素,在预测 2 型糖尿病时甚至优于单个基因变异或多基因风险评分。
这就是为什么综述强调:基因组信息最有价值的时候,是作为更广阔多维画像的一个组分,而不是单独作为制定饮食处方的依据。
第二层:代谢组——“此刻的身体快照”
代谢组学:捕捉机体动态变化的代谢特征
如果说基因是静态的,代谢组就是动态的。通过分析生物样本中的内源性和外源性小分子代谢物,代谢组学能客观捕捉饮食暴露、生物活性化合物,以及饮食引起的宿主代谢通路改变。常用的检测平台包括核磁共振(NMR)和质谱(MS),分靶向与非靶向两类策略。
与血糖调节、脂质代谢、氨基酸代谢相关的代谢特征,已被关联到胰岛素抵抗、T2DM、肥胖等代谢紊乱。例如,血清代谢谱能识别糖尿病相关生物标志物;脂质、酰基肉碱和支链氨基酸特征则提供代谢功能障碍的额外信息。
脂质与脂肪酸相关证据进一步显示,这种代谢异质性与脂蛋白组分、膳食脂肪酸构成、脂肪酸链长、组织背景和疾病状态都有关联。
多重因素共同塑造个体差异
注意这些代谢物高度相互关联,并受饮食、疾病状态、宿主基因、菌群和环境共同影响。因此它们的价值,不在于某个孤立的生物标志物,而在于多个变量集合起来构成的多变量模式。
正因如此,同一份食物,在不同人身上引发的餐后血糖、血脂、胰岛素反应各不相同——这不是测量误差,而是身体当下状态的真实映照。
第三层:个体化营养预测中的重要数据层
肠道菌群是个体化营养中不容忽视的个体差异来源,也是本文关注的重点之一。它既受长期饮食习惯影响,也可能通过营养物质转化、微生物代谢物生成及宿主能量稳态等途径,参与调节代谢反应。已有研究发现,肠道菌群特征与肥胖、2 型糖尿病(T2DM)及多种炎症性疾病相关,因此,菌群信息具有作为个体化营养评估潜在生物标志物的研究价值。
肠道菌群对 AI 辅助精准营养尤其重要,因为它具有高维、复杂且高度依赖情境的特点。菌群组成与功能可能随饮食、药物、生活方式和宿主生理状态而变化;单独分析某一类菌群,往往难以解释个体的完整代谢反应。将菌群的群落结构与功能特征,同遗传、代谢、饮食及生理指标等多层数据整合,或有助于提升个体化反应预测能力。
在这一方向上,谷禾健康已积累近 7 万例糖尿病相关样本,并尝试结合 AI 构建糖尿病预测模型。这类实践体现了将微生物组数据用于代谢健康评估的价值。
TIPs: 基因组、代谢组、肠道菌群,各自都不完整,互补才接近全貌。
要理解菌群为什么是“芯”,得先接受它的两个核心属性:双向与动态。
双向:饮食改造菌群,菌群又改造你的代谢
饮食—菌群的互作是动态且双向的。地中海饮食这类饮食模式,能改变菌群组成与代谢物产生,包括短链脂肪酸(SCFA);而较不友好的饮食模式,则可能与菌群多样性下降和促炎的代谢特征相关。换句话说,你吃什么,决定了养出什么样的菌;而养出什么样的菌,又反过来决定你能从食物里“提取”到什么。
这里藏着个性化营养最日常也最关键的一环:
膳食纤维等功能性成分,很多并不是直接作用于人体,而是先被肠道菌群发酵转化,再以 SCFA 等代谢物的形式影响你的血糖、炎症与食欲。
因此,基线菌群不同的人,面对相同饮食时,可能产生不同的微生物和代谢反应。这为“同饭不同糖”提供了一种微生物层面的解释。
一个精巧的“面包实验”
Korem 团队开展了一项随机交叉试验:20 名健康人分别连续一周食用传统酸面团全麦面包和工业白面包。
两种面包在整体临床指标上的平均差异不显著,但参与者的餐后血糖反应存在明显个体差异,有些人对两种面包的反应方向甚至相反。研究还发现,基线肠道菌群特征与这些差异相关,并显示出一定的预测能力。
编辑
30 种菌与“健康/不健康”饮食的关联
在 PREDICT 1 中,Asnicar 团队对 1,098 名参与者做了深度表型分析,识别出 30 种与健康或不健康饮食模式及心血管代谢指标相关的微生物物种。更关键的是,菌群衍生的特征能在热量和营养素摄入之外,独立地为餐后反应预测做出贡献。这从数据层面证明菌群是有独立信息量的预测因子。
从“预测”走向“干预”:6 个月的验证
研究正从“能预测反应”走向“据此定制饮食并改善结果”。在为期 6 个月的 PERSONAL 随机对照试验中,机器学习得出的“餐后靶向(PPT)饮食”,在糖尿病前期成人中带来的血糖控制改善优于地中海饮食,且优势维持到 12 个月随访。
后续整合分析进一步显示:饮食引起的微生物丰富度与组成变化,与心血管代谢结局的改善相关联。而基于饮食变化和基线临床特征的机器学习模型,还能预测个体对 6 个月干预的反应。这条“菌群→饮食→代谢结局”的链路,正在被真实的人体试验一环环验证。
对生活的启示:先养菌,再谈“精准”
在 AI 算法真正走进日常饮食管理之前,菌群研究已提供了一些实用启示:饮食多样化、增加膳食纤维摄入,并以植物性食物为主,可能有助于维持肠道菌群和代谢健康。
更进一步的个体化建议——例如根据菌群特征判断哪类纤维或发酵食品更适合自己——正是 AI 希望探索的方向。
读到这里,你可能觉得“技术厉害”。但作为长期深耕这一领域的从业者,我们更关心的不是技术参数有多亮眼,而是一个更关键、更贴近临床实际的问题:在真实的病人身上,这些工具真的改善了结局吗?
为了回答它,研究建立了五级证据框架,从低到高依次是:
技术有效性(模型相关性、判别力、预测误差)
外部有效性(在独立人群或场景中的可复现性)
临床有效性(前瞻性研究中预设临床/代谢终点的改变)
实施有效性(真实世界中的可行性、依从性、参与度)
患者重要结局(发病率、重大临床事件、生活质量或死亡)
编辑
最成熟的一块:2 型糖尿病与血糖管理
如果说 AI 个性化营养有一个“高光区”,那就是血糖管理。这里既有机制性队列研究,也有 RCT,还有真实世界落地证据。
个性化饮食干预:从血糖改善到糖尿病缓解
PERSONAL 试验把 225 名糖尿病前期成人随机分到“AI 驱动的餐后靶向(PPT)饮食”(结合 ML 饮食个性化与 CGM 联动的手机应用)或地中海饮食,持续 6 个月。结果,个性化组每日血糖高于 140 mg/dL 的时间减少更多(−1.3 vs −0.3 小时/天,P < 0.001),HbA1c 降幅也更大(−0.16% vs −0.08%,P = 0.007),且这些差异维持到 12 个月随访。
编辑
但是该干预把算法个性化与 CGM 监测、App 反馈、反复的参与者互动打包在一起,所以观察到的获益不能单独归功于 AI 算法本身——它评估的是整个“AI 赋能干预包”的有效性。
在新诊断的 T2DM 中也有相似发现:一项 23 人随机交叉试验显示,2 周 PPT 饮食相比地中海饮食显著改善 CGM 结局(餐后血糖均值差 −19.8 mg/dL×h、平均血糖 −7.8 mg/dL、高于 140 的时间 −2.42 小时/天,均 P < 0.001)。
随后的 6 个月开放标签干预(16 人)使 HbA1c 下降 0.39%、空腹血糖下降 16.4 mg/dL、TG 下降 49 mg/dL;61% 的参与者达到糖尿病缓解(HbA1c < 6.5%),而代谢改善与个体肠道菌群变化相关。
另一条独立证据线问的是:全自动 AI 能不能比肩人类?在一项 3 期实用性非劣效 RCT 中,368 名糖尿病前期合并超重/肥胖者被随机分到全自动 AI 驱动的糖尿病预防计划(DPP,用强化学习算法通过 App 与蓝牙体重秤推送个性化提醒)或远程人类教练 DPP,为期 12 个月。主要复合终点达成率:AI 组 31.7% vs 人类教练组 31.9%,满足预设的 −15% 非劣效边际;而且 AI 组的项目启动率更高(93.4% vs 82.7%)。
从临床试验走向真实世界:用户参与度决定干预成效?
真实世界证据也在补充:在 3,148 名 AI 驱动 App 型 DPP 用户中,最低记录体重时平均减重 4.2%,35% 的用户实现至少 5% 的减重;完成 CDC 课程要求者 12 个月减重 5.3%,未完成者3.3%(P = 0.015)。
逻辑回归还发现,与 AI 教练互动的天数(β = 0.43)和每周至少自测两次体重(β = 0.68),是临床有意义减重的显著预测因素——用户参与度,很可能是有效性的关键变量。
编辑
有待继续验证和完善:肥胖与体重管理
肥胖看起来是 AI 饮食个性化最理所当然的靶点,但现有试验证据表明:算法层面的个体化,并不必然带来更好的减重结果。
个性化饮食推荐:算法优势未必转化为减重优势
最有信息量的当属 Personal Diet Study:
一项单中心 6 个月 RCT,把 204 名肥胖合并糖代谢异常成人(平均 BMI 33.9)随机分到“ML 个性化饮食”(算法预测个体餐后血糖,App 给出颜色编码的餐食评分)或“标准化低脂饮食”。
结果,6 个月减重组间无显著差异(低脂组 −4.31% vs 个性化组 −3.26%;组间差 1.05%,95% CI −0.40 到 2.50,P = 0.16)。不过,个性化组的自我监测依从性更高(54.3% vs 41.1%)——这些因素是否中介了减重结果,尚待专门的中介分析。
个性化行为干预:找准时机可能比调整食谱更重要
另一条思路不去个性化饮食内容,而去个性化行为支持的时机与方式。
编辑
Forman 等的即时自适应干预(JITAI)概念验证 RCT 纳入 181 名超重/肥胖者(平均 BMI ≈ 34.3),在商业数字减重程序基础上加或不加 OnTrack 应用——该应用的 ML 模型预测“即将发生的饮食失控”风险,在高危时刻推送定制干预。在 Beyond the Scale 程序中,OnTrack 组 10 周减重 4.7%,对照组 2.6%(交互 P = 0.002)。但模型预测精度与减重幅度的关系仍待厘清。
综合这些试验:
AI 个性化的增量收益不一致,更多取决于“如何与干预情境整合”。
原型多,对照证据少:心血管与高血压
饮食在心血管预防中地位核心,按理说证据应该成熟,但现实是仍由工程原型和单臂研究主导,而非对照试验。
AI 个性化干预在血压管理中展现初步成效
目前临床进展最靠前的是一份 24 周单臂研究:141 名高血压成人使用一个全自主数字平台,采集生活方式与血压数据,构建个性化 ML 模型预测每个人的血压,并自动给出符合循证指南的生活方式建议。
结果 SBP/DBP 在 12 周下降 5.6/3.8 mmHg,24 周下降 8.1/5.1 mmHg;基线 2 期高血压者 24 周降幅达 14.2/8.1 mmHg,血压达标比例增加 26.5%,参与度 92%,仅 5.9% 需人工干预。但没有对照组,限制了因果推断。
算法表现亮眼,临床有效性尚待验证
更早的 Sookrah 等则描述了基于 ML 的 DASH 推荐系统(决策树 J48 + 协同过滤),技术准确率高,但尚未验证临床结局。心血管领域于是成了“技术开发与临床验证之间那道裂缝”的典型代表。
回溯性、诊断性为主:癌症营养与支持治疗
AI 驱动的癌症营养不良筛查与分级
营养不良和恶病质在癌症患者中常见、预后意义重大,却常被低估,因此成了自动营养风险评估的潜在靶点。
Sguanci 等的系统综述认为,AI 可支持自动营养不良筛查、基于影像的身体成分评估(如 DL 识别 CT 上的骨骼肌)和个性化营养干预,但多数模型仍缺乏外部验证和前瞻性临床获益证据。
迄今最大的研究之一分析了 14,134 名中国癌症患者(INSCOC 队列)。无监督聚类识别出一个营养良好簇(占 58.0%)和三个轻、中、重度营养不良簇,与 PG-SGA 及 GLIM 标准呈中等一致性;营养不良越重,生存越差;多项逻辑回归表现最佳,在验证集上近乎完美地完成了营养不良分级。
编辑
癌症恶病质的智能筛查(尚需临床验证)
针对癌症恶病质,一项 3,896 名患者的多中心回顾性队列(含 471 例前恶病质、1,178 例恶病质)用 ML 找出了最有信息量的临床特征:食物摄入改变、上臂中围、高密度脂蛋白胆固醇、C 反应蛋白/白蛋白比值。
逻辑回归对恶病质筛查的 AUC 为 0.830,前恶病质诊断为 0.701,校准良好、决策曲线表现不错——研究不仅评估了判别力,还评估了校准与潜在临床效用。
但证据仍以癌症恶病质的智能筛查与临床验证挑战为主,需要干预性 RCT 来确认 AI 指导的营养管理能否改善肿瘤结局或生存。
微生物组靶向干预:从“普通益生菌”到“按菌群选菌”
益生菌是有明确菌株身份的、非致病微生物,可通过影响微生物代谢、病原体定植和宿主—微生物互作来调节宿主生理。近年,微生物组靶向策略已从常规益生菌,扩展到按疾病相关的微生物与功能特征筛选的“下一代菌株”。
从 AI 辅助精准营养的角度看,这些干预的核心价值不在于“益生菌的一般机制”,而在于:能否用基线菌群与多组学特征,预测谁最可能对某种特定的微生物组靶向干预有反应。
干预性证据有限但正在出现:一项随机、双盲、安慰剂对照多中心试验中,健康老年人 12 周口服含两歧双歧杆菌 BGN4 和长双歧杆菌 BORI的益生菌,改善了认知灵活性和心理压力(菌群变化用 16S rRNA 基因测序评估)。
AI 可在两个层面发力:
一是纳入基线菌群特征的 ML 模型,帮助预测个体对特定干预的反应(前文血糖反应模型即是代表,菌群组成对 PPGR 预测有贡献,代谢改善与个体菌群变化相关);
二是多组学 ML 框架,把干预反应与微生物特征关联起来——例如用粪便代谢组和菌群谱预测儿童克罗恩病对全肠内营养(EEN)的反应。但评估 AI 指导益生菌选择的前瞻性试验,目前尚未开展。
编辑
小样本,但方向有意思:胃肠疾病
AI 辅助饮食干预与胃肠道症状改善
饮食治疗是肠易激综合征(IBS)和炎症性肠病(IBD)管理的主要手段,但排除饮食难以个性化、也难坚持,于是给 AI 工具留出了空间。
该领域首个 RCT 把 58 名 IBS 患者随机分到 AI 辅助饮食应用(Heali,支持低 FODMAP 饮食实施)或常规饮食教育,持续 4 周。完成者分析中,应用组生活质量改善更大(31.1 vs 11.8 分,P = 0.04),IBS 症状严重度额外下降 24%(未达统计显著),应用组对排便习惯的不满意程度改善幅度约为对照组的两倍(P = 0.05)。
一项 9 周单臂试点进一步探索了个性化排除饮食:37 名参与者(16 例 IBS、9 例 IBS 合并克罗恩病、12 例 IBS 合并溃疡性结肠炎),ML 工具识别出每个人最强的 3–5 个食物触发因素并据此生成个性化排除饮食。中期 81% 报告症状显著改善,终点 70% 维持改善、67.6% 完全缓解、89% 生活质量改善,日常参与度 95%、依从性 89%——但无对照组,解释受限。
多组学驱动的营养治疗应答预测
第三项研究把个性化从“症状导向”转向“机制导向”:在 37 名活动性克罗恩病儿童中,用 ML 预测对 EEN 的粪便钙卫蛋白反应。
应答者(15/37)基线粪便丁酸、乙酸、苯乙酸更低、微生物丰富度更高;一个结合粪便代谢物、饮食数据和菌群的多组学模型,能有效预测对 EEN 的无应答。
这些发现展现了一定的应用潜力,但样本仍小(n = 37–58),在 AI 个性化饮食治疗能常规进入胃肠病实践之前,需要足够效力的 RCT。
AI 与个性化营养的结合,正在从研究走向应用。它能否真正帮助人们,关键不只在算法,而取决于数据基础设施、数据是否可靠、不同人群是否被充分纳入以及建议能否经过临床验证并安全地融入日常生活。
个性化营养其实无需复杂的检测或昂贵的设备。倾听身体对食物的真实反馈,维持多样而均衡的日常饮食,同时对新技术保持好奇、对夸大宣传保有审慎,本就是迈向健康最扎实的一步。
随着多组学检测、连续健康监测与人工智能不断发展,个体化健康评估正从设想走向实践。谷禾等企业也在持续积累数据、打磨技术,探索如何将肠道菌群、遗传背景、饮食习惯与代谢特征等信息整合起来,绘制更贴合个体的“健康地图”。它不会替代专业诊疗,却有望为日常健康管理提供更清晰的参考,帮助每个人逐步找到更适合自己的生活方式。
谷禾健康
人工智能(AI)几乎进入了所有行业,代码秒生成、数据处理效率翻倍,在几秒钟内完成过去需要几小时甚至几天才能完成的信息处理工作。那么,这股AI浪潮会重塑生命科学与医学吗?
放在微生物研究领域,答案是肯定的。更值得讨论的是, AI 正在以什么方式进入微生态研究,又会把这个行业推向哪里?
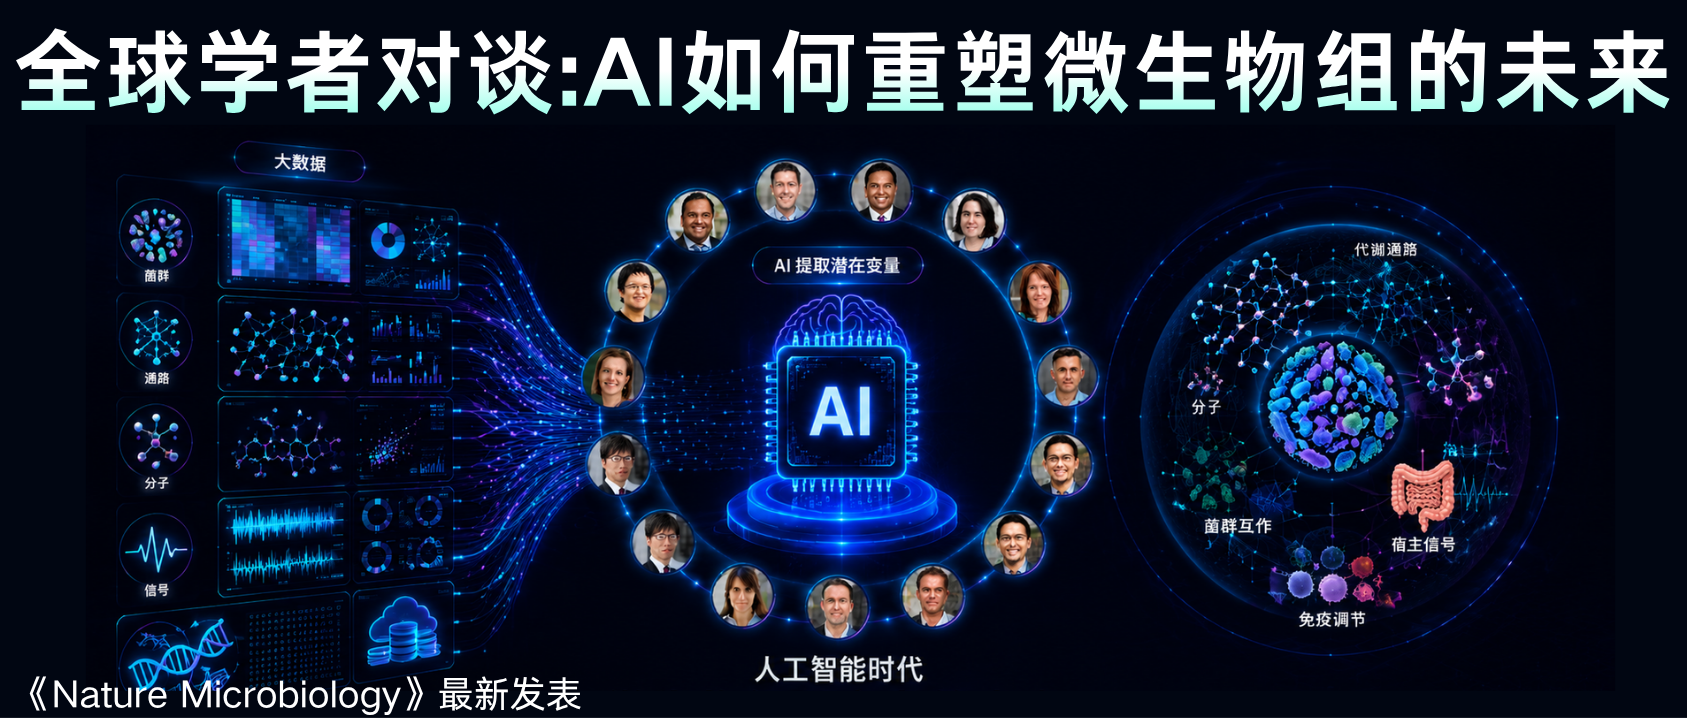
近日,《Nature Microbiology》邀请多位全球微生物组领域研究者,讨论 AI 对微生物组研究的影响。
这些科学家的观点并不单一。他们既看到了 AI 在复杂数据分析、多组学整合、临床变量提取、代谢物发现、疾病预测等方面的巨大潜力,也极具前瞻性地强调:AI 不是魔法,它不能绕过数据质量、实验验证和科学判断。
这篇讨论很有价值,它没有把 AI 描述成一个万能答案,也没有把 AI 看成科研的威胁。AI 正在成为微生态研究的一种新基础设施:它帮助人类更快地看见复杂数据中的线索,帮助科学家提出更有价值的问题,也帮助科研、临床、大健康和产业应用之间建立新的连接。
而在这背后,一个更加清晰的行业趋势正在出现:AI 能让微生态研究跑得更快;而一场关于数据与真实世界场景的终极较量,才刚刚开始。
菌群研究,本质上是在研究一个高度复杂的生命生态系统。菌群之间会相互竞争、协作,也会影响代谢产物、免疫反应、肠道屏障、炎症水平,甚至与药物反应、饮食结构和疾病进展发生联系。
以色列魏茨曼科学研究所的Eran Elinav教授提到,微生物组领域可以从 AI 革命中受益很多。
因为这个领域面对的正是复杂的微生物群、跨物种相互作用,以及生物活性代谢物与其微生物来源之间的关系。
也就是说,AI 最适合介入的地方,正是人类很难直接看清的复杂关系。
过去,研究者经常是先观察现象,再逐步寻找解释;而现在,AI 可以帮助科学家在海量数据中提前发现可能被忽视的线索,让研究从人工寻找线索进入机器辅助提出假设的阶段。
在微生态研究中,数据从来不缺。
宏基因组、代谢组、蛋白组、转录组、免疫指标、临床变量、电子病历、饮食记录、随访数据……这些数据越积越多,那么怎么样从大量信息中找到重要的部分?
从海量候选中,找到最值得验证的信号
美国匹兹堡大学的 Reinhard Hinterleitner 研究微生物代谢物如何影响免疫反应。
他提到,现在很多时候最难的并不是收集数据,而是判断哪些代谢物最可能具有生物活性,并且与疾病真正相关。
在过去,耗费无数科研人员大把青春的,往往不是实验本身,而是先观察到现象,再在长长的候选名单里“撞大运”去寻找解释… 在生命科学里,重要的是找到哪些差异值得继续深入研究下去。如果 AI 能够帮助科学家更快完成筛选,科研效率就会发生实质性变化。
这正是 AI 能降维打击的地方。
AI 可以从很长的候选名单中,帮助研究者优先筛选更值得验证的代谢物。它不是直接替科学家完成结论,而是让研究者更快把注意力集中到最有可能产生价值的方向上。
AI正在扩大微生态研究的搜索半径
Karen P. Scott 教授也提到,随着 DNA 测序数据大量产生,分析工作耗时巨大,很多数据甚至还没有被充分挖掘。
机器学习工具可以帮助研究者更高效地从巨大数据集中发现新的抗菌蛋白和细菌素。
未来,研究者不一定只依赖序列同源性,而可以结合蛋白质三维结构和靶点相互作用,寻找具有潜在活性的序列。
这说明 AI 在微生态领域的应用,不仅停留在分析菌群结构,还可能深入到新型抗菌物质发现、微生物功能预测和药物开发的早期阶段。
编辑
从这个角度看,AI 正在扩大微生态研究的搜索半径。过去我们只能在有限区域内寻找答案;现在,AI 可以帮助人类把更多被忽略的角落纳入视野。
AI 的本质,不是消灭科学家的工作,而是把科学家从科研高级打字员中解救出来,当工具把寻找线索的速度拉到极致时,他们可以把精力留给科学直觉。
一种菌的变化,可能只是结果,不一定是原因;一个代谢物的升高,可能与疾病相关,但不一定就是治疗靶点;同一种菌群结构,在不同饮食、不同年龄、不同疾病背景下,也可能意味着完全不同的事情。
这也是为什么 AI 的价值不仅是算得更快,而是整合得更多。
编辑
比利时根特大学Gerard Bryan Gonzales 提到,AI 可以帮助科学家从大数据中提取潜在变量,在降低维度的同时保留生物学意义。这些潜在变量可能是共同出现的菌群组合,也可能是通路、分子特征或更复杂的生物信号。
从单个指标,走向多组学网络
这句话背后的意义是:AI 可以帮助研究者不再孤立地看某一个菌、某一个指标,而是把微生态系统看成一个整体。
编辑
比利时安特卫普大学的 Sarah Lebeer 也提到,AI 正在帮助微生物组研究整合不断扩大的多组学数据,并把它们组织成更连贯的生物网络。
虽然她重点研究的是阴道微生物组,并提醒不同生态位之间不能简单套用模型,但她的观点同样适用于整个微生态领域:AI 的价值不只是发现差异,而是帮助我们建立网络化、系统化的理解。
未来,研究者更需要理解网络:菌群如何影响代谢物,代谢物如何作用于宿主细胞,宿主免疫状态又如何反过来影响微生态结构。
从看见差异到理解关系,这是微生态研究走向成熟的重要一步。
从静态结构,走向动态演化
编辑
葡萄牙古尔本基安分子医学研究所的 Isabel Gordo 则进一步提醒我们,肠道菌群并不是静止不变的结构。时间序列宏基因组测序已经显示,肠道中的菌株会在宿主体内持续变化,甚至发生快速演化。
是什么驱动了这种进化,以及肠道细菌中特定遗传改变在多大程度上可以作为某种疾病背景的生物标志物,都是具有挑战性的开放问题。
AI 模型可用于挖掘并整合过去一个世纪在微生物遗传学中积累的知识,以及过去十年的微生物组数据,从而帮助回答这一挑战。
这种转变会影响整个行业。
编辑
如果说基础研究关注的是机制,那么临床和真实世界更关注的是:这些研究发现能否在人群中得到验证?
在这方面,AI 的作用同样明显。
当菌群数据遇见电子病历
编辑
梅奥诊所的 Purna Kashyap 教授提到,AI 已经改变了他们从电子健康记录中提取临床结局和复杂临床变量的方式,尤其是在大规模人群数据中。这有助于更好地识别与疾病和结局相关的微生物信号,也可以帮助寻找可能被微生物影响的宿主通路。
这意味着,微生态研究正在从实验室数据走向真实世界数据。
过去,科研可能主要围绕样本和测序结果展开;现在,如果菌群数据能与电子病历、临床指标、生活方式、饮食、用药、随访结局结合,就可能为疾病风险评估、治疗反应预测和个体化健康管理提供新的参考维度。
从算法预测到生物学验证
编辑
日本大阪大学的 Kiyoshi Takeda 教授也提到,微生物与宿主之间的相互作用发生在一个高度复杂的系统中。
AI 可以通过患者和健康个体之间的比较分析,帮助识别疾病相关的肠道微生物、微生物来源的代谢物,以及这些代谢物可能作用的宿主细胞或受体。随后,研究者可以通过小鼠模型等生物学研究验证这些预测,并推动其向人类疾病应用转化。
AI 先帮助发现可能的关联;
实验进一步验证机制;
临床研究再判断它能否用于人群。
AI 让医学和微生态研究之间多了一座桥。
编辑
爱尔兰科克大学的 Niall Patrick Hyland 关注宿主-微生物界面,尤其是微生物组如何影响肠道生理。他认为,随着实验数据越来越复杂,AI 可以更客观地识别生理读数中的模式,减少人为偏差,发现原本难以辨认的信号。
同时,AI 在模拟微生物组与药物、外源化合物相互作用方面也有潜力,有助于理解个体反应,并推动微生态治疗的发展。
这一点也很重要。
这些问题,都可能与微生态有关。AI 的作用,就是帮助我们把这些复杂因素重新组织起来。
AI 对微生态研究的影响,并不只体现在数据分析上。它也在改变科研工作的组织方式。
AI正在进入科研的应用流程
编辑
哈佛医学院的 Marco Jost 提到,机器学习早已是微生物组研究中的常用工具,尤其是在大型组学数据中提取生物信号。
但近几年大语言模型带来的变化,更多发生在科研行为本身:它们可以自动化一些繁琐的实验室任务,生成代码初稿,帮助研究者快速了解陌生领域。
编辑
杜克大学的 Lawrence A. David 也提到,AI 可以放大科研努力。
在他的实验室中,AI 不仅用于管理复杂项目流程,还能把成千上万条食品成分清单转换成用于基因组数据库的精确拉丁物种名称。过去这些任务可能需要研究者花费大量时间,现在可以大幅加速。
这些例子说明,AI 正在进入科研工作的底层流程。
它可以整理资料、清洗数据、管理流程、辅助编程、提取元数据、识别错误、汇总文献。看似都是辅助工作,但长期来看,它会改变科研团队的时间分配。
科学家的价值重心正在转移
未来,AI 承担更多基础工作后,人类科学家的价值会更加集中在提出问题、判断方向、设计实验和解释结果上。
编辑
Lawrence A. David 因此提出一个值得思考的问题:既然 AI 越来越擅长写作、编程和统计分析,我们应该如何重新训练未来科学家?
他的答案是,未来更应该重视科学素养,包括:
这句话对所有行业都有启发。
在万物皆可被大模型自动化的时代,当工具越来越强,完成某个技术动作不再是门槛,重要的是是否知道应该把工具用在哪里;难的是提出连 AI 都没想到的问题;当 AI 给你一个漂亮答案时,你依然有底气去质疑它是否靠谱。
AI 时代,科学家的门槛并没有降低,只是门槛换了位置。
谈 AI 的价值,并不意味着忽略它的边界。相反,越是步入生命科学和健康领域的深水区,越需要清楚地知道 AI 能做什么,不能做什么。
Eran Elinav 教授提醒,AI 的表现取决于输入数据的质量。它最多可以生成更有信息量的相关性、关联和预测,但理解因果关系和分子机制,仍然需要严谨的实验验证。
这是微生态研究中非常核心的一点。
相关性,不等于因果性
某种菌和某种疾病同时出现,不代表这种菌就是病因。某个代谢物和某种健康状态相关,也不代表它就是干预靶点。AI 可以告诉我们,这里可能有信号,但不能自动证明这就是原因。
Purna Kashyap 也提醒,微生物组数据高度稀疏、维度高、非常依赖具体背景。如果再叠加批次效应、研究设计差异和功能注释不完整,AI 模型可能会过拟合,也可能识别出没有生物因果意义的相关性。
模型越复杂,不一定越可靠
编辑
Sean M. Gibbons 的观点更加直接。他认为,对于许多只有几百到几千个样本的生物医学数据集,训练新的深度学习模型在统计上并不总是可行。很多时候,参数更少的传统机器学习模型反而更合适。
他还提醒,不能盲目相信 AI 热潮,而应该用人的判断力谨慎地使用 AI。
AI 能提高效率,但不能替代证据等级。
AI 能发现模式,但不能自动完成因果解释。
AI 能生成结论的雏形,但不能承担科学判断的责任。
在微生态领域,这一点尤其重要。
越复杂的领域,越需要强大的工具;也越需要清醒的边界。
尽管科学家们不断提醒 AI 的边界,但他们对 AI 推动微生态研究的未来仍然保持积极态度。
疾病关联 → 治疗反应预测
编辑
希腊亚历山大·弗莱明生物医学科学研究中心的 Vasiliki Koliaraki 提到,AI 正在改变我们研究肠道微生物组的方式。
基于宏基因组数据训练的机器学习模型,已经可以识别与炎症性肠病诊断和治疗反应相关的微生物模式。
未来,这些能力有望进一步帮助临床前研究,改进我们对微生物组—宿主相互作用的建模,预测哪些微生物可能推动肠道疾病,并设计更有针对性的干预策略。
多组学模式 → 机制理解
编辑
密歇根州立大学的Robert A. Quinn 则从代谢组学角度谈到,他们实验室长期使用 AI 工具分析复杂多组学数据,如今更依赖 AI 解释大规模代谢组数据,发现人工难以识别的微生物化学模式。
他还提到,深度学习方法正在被用于预测多组学数据中的生物关系,并且在识别模式方面表现出优于传统统计分析的潜力。
这些观点共同指向一个趋势:微生态研究正在从描述走向预测,再进一步走向机制理解。
构建“人体-微生物”复合模型
编辑
来自阿根廷立陶宛国立大学的Gabriel Vinderola 提到,他们参与的 Global Microbiome Conservancy 汇集了来自非洲、亚洲、南美和欧洲二十多个国家研究者,关注全球人类微生物组,并加强历史上代表性不足人群的研究能力。
AI 和机器学习工具可以整合宏基因组、分离菌株基因组、代谢组、免疫标志物和临床表型,同时帮助拆解生活方式、饮食、地理和宿主遗传等因素之间的相关驱动关系。
他的判断很有代表性:微生态研究正在从以描述为主,转向预测性、机制性,甚至生成式的人体metaorganism模型。
注:这里的metaorganism,可以理解为人与体内微生物共同构成的复合生命系统。
当 AI 越来越强,很多人会自然把注意力放在算法、模型和算力上。
在微生态领域,稀缺的东西可能还不只是算法
编辑
Paul W. O’Toole 教授提到,他们已经多年使用监督式机器学习,识别基因组或宏基因组中能预测表型和宿主特征的关键特征。
他们还使用自然语言处理进行元数据整理,筛选超过 12000 条生物样本记录并标记错误;同时,也在利用粪便宏基因组数据进行结直肠癌检测,并通过隐私保护的联邦 AI,让患者元数据不离开诊所。
这说明,AI 要进入医学和健康场景,数据治理、隐私保护、样本质量、元数据标准化同样重要。
没有这些基础,AI 很难稳定发挥价值。
Sean M. Gibbons 也提醒,大模型并不适合所有场景。对于许多生物医学数据,样本量、参数量和统计可行性之间需要匹配。
模型越复杂,不一定越好;在数据不足或结构不清晰的情况下,复杂模型反而可能带来更大的不确定性。
编辑
微生态行业的关键能力正在重新排序
这给整个行业一个非常现实的提醒:
AI 不是把少量、混乱、低质量的数据变成高质量科学的机器。它只是把数据中的信号和问题,一起放大。如果喂给它的是贫瘠与混乱,它撬动的绝非科学的真相,而是一场更大规模的统计学灾难。
因此,在 AI 时代,微生态行业的关键能力会重新排序。
第一,持续产生高质量数据。
第二,建立标准化流程。
第三,连接真实世界场景。
第四,把菌群数据与饮食、临床、代谢、免疫、生活方式、长期随访结合。
第五,把 AI 发现的模式转化为专业、审慎、可验证的解释。
这些是微生态行业真正的底层能力。
回到产业层面,肠道菌群检测的意义也需要被重新理解,检测是微生态数据体系的重要入口。
AI再聪明也是吃喂进去的数据
数据对于科研、大健康、临床研究、营养干预、产品开发、疾病风险管理和个体化健康服务,都可能具有长期价值。
编辑
数据连接真实场景,产生长期价值
当然,数据的价值不只是多。也需要的是长期、真实、标准化、可解释,并且能够与具体健康场景连接。
AI 会提高微生态研究和应用的效率,但真正支撑行业长期发展的,仍然是数据积累、标准体系、场景转化、科学验证等。
AI正在推动微生物学进入一个发现更快、理解更深的阶段,也让大量沉睡在数据中的线索重新显现,推动了整个研究视角的升级。
菌群检测行业的长期价值,建立在可信的数据之上。随着检测标准、数据体系和验证路径日益完善,当高质量数据持续沉淀,微生态领域将形成更清晰的证据链,这也为产业上下游协作提供更扎实的基础。
谷禾也将继续围绕这一入口,通过长期、真实、标准的动态数据积累,将 AI 的算力与高质量的真实世界数据深度耦合,推动微生态研究成果更稳健地走向科研转化、产业协同和大众健康应用。
主要参考文献:
Sharma, A. Voices of microbiome researchers in an artificial intelligence era. Nat Microbiol (2026). doi.org/10.1038/s41564-026-02359-7